Les k plus proches vosins
L'apprentissage supervisé, est très utilisé en informatique. Il sert notamment pour la reconnaissance de caractères, identifier des objets sur une image, la conduite assistée...
Essayons de comprendre comment cela est possible.
Classification: c'est associer à chaque élément d'un ensemble une classe. par exemple un caractère, un nombre, une espèce, une catégorie.
Un exemple historique : Les iris de Fisher
Nous allons mettre en oeuvre un premier algorithme de classification supervisé. C'est à dire qu'à partir d'un echantillonage donné et correctement classifié, nous allons essayer de déterminer la classe un élement inconnu.
Le jeu de données Iris connu aussi sous le nom de Iris de Fisher ou Iris d'Anderson est un jeu de données multivariées présenté en 1936 par Ronald Fisher dans son papier The use of multiple measurements in taxonomic problems comme un exemple d'application de l'analyse discriminante linéaire[1]. Les données ont été collectées par Edgar Anderson afin de quantifier les variations de morphologie des fleurs d'iris de trois espèces[2]. Deux des trois espèces ont été collectées en Gaspésie. « Toutes sont du même champ, cueillies le même jour et mesurées le même jour par la même personne avec les mêmes outils de mesures[3]. »
Le jeu de données comprend 50 échantillons de chacune des trois espèces d'iris (Iris setosa, Iris virginica et Iris versicolor)
D'après Wikipédia
Avant cela, quelques notions vont nous être utiles:
- savoir calculer une distance
- représenter graphiquement des nuages de points
La distance : euclidienne et de Manhathan
1. Distance Euclidienne
La distance euclidienne est la distance "à vol d’oiseau" entre deux points dans un espace euclidien. En 2D, pour deux points \( A(x_1, y_1) \) et \( B(x_2, y_2) \), elle est donnée par :
\[
d_{eucl}(A, B) = \sqrt{(x_2 - x_1)^2 + (y_2 - y_1)^2}
\]
💻 Exemple Python, dans le plan avec des coordonnées de type (x,y)
| Python |
|---|
| def distance_euclidienne(p1, p2):
return ((p1[0] - p2[0]) ** 2 + (p1[1] - p2[1]) ** 2) ** 0.5 # ** 0.5 correspond à la racine carrée
|
Exemple
print(distance_euclidienne((1, 2), (4, 6))) # Résultat : 5.0
2. Distance de Manhattan
La distance de Manhattan, aussi appelée distance L1, mesure la distance entre deux points en suivant uniquement des mouvements horizontaux et verticaux — comme dans un plan de ville à angles droits (d'où son nom).
Pour deux points \( A = (x_1, y_1) \) et \( B = (x_2, y_2) \), la distance de Manhattan est donnée par :
\[
d_{\text{Manhattan}}(A, B) = |x_2 - x_1| + |y_2 - y_1|
\]
Ce concept se généralise facilement à des vecteurs de dimension \( n \) :
\[
d_{\text{Manhattan}}(A, B) = \sum_{i=1}^{n} |a_i - b_i|
\]
💡 Exemple
Considérons deux points en 2D :
- \( A = (1, 2) \)
- \( B = (4, 6) \)
Alors :
\[
d_{\text{Manhattan}}(A, B) = |4 - 1| + |6 - 2| = 3 + 4 = 7
\]
💻 Implémentation en Python
| Python |
|---|
| def distance_manhattan(p1, p2):
return abs(p1[0] - p2[0]) + abs(p1[1] - p2[1])
|
Exemple
print(distance_manhattan((1, 2), (4, 6))) # Résultat : 7
Représenatation graphique d'un nuage de points
Nous allons construire 3 nuages de points à partir de ce ficher csv : iris.csv
Comme dans la partie du programme sur les données en table, nous utilisons le module Python csv.
| Python |
|---|
| file = open('iris.csv','r')
reader = csv.DictReader(file)
iris_set = [ dict(line) for line in reader]
|
La représentation graphique à obtenir
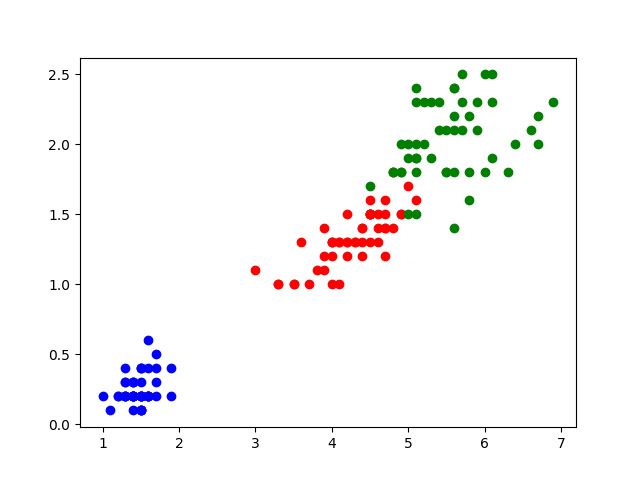
code Python:
| Python |
|---|
| import matplotlib.pyplot as plt
import csv
file = open('iris.csv','r') # r pour mode lecture read
reader = csv.DictReader(file)
iris_set = [ dict(line) for line in reader]
# Une double boucle, pratique pour la suite
# Pour passer des chaînes de caractères (import csv) aux valeur flottantes :
for iris in iris_set:
for k,v in iris.items():
iris[k] = float(v)
x0 = [ iris['petal_length'] for iris in iris_set if iris['species'] == 0]
y0 = [ iris['petal_width'] for iris in iris_set if iris['species'] == 0]
x1 = [ iris['petal_length'] for iris in iris_set if iris['species'] == 1]
y1 = [ iris['petal_width'] for iris in iris_set if iris['species'] == 1]
x2 = [ iris['petal_length'] for iris in iris_set if iris['species'] == 2]
y2 = [ iris['petal_width'] for iris in iris_set if iris['species'] == 2]
plt.scatter(x0, y0, color='blue')
plt.scatter(x1, y1, color='red')
plt.scatter(x2, y2, color='green')
plt.show()
|
l'algorithme des k plus proches vosins
| Python |
|---|
| def distance(x1: float,y1: float,x2: float ,y2:float) -> float:
return (x2 - x1) ** 2 + (y2 - y1) ** 2 # Pas besoin de calculer la racine carrée car les distances sont juste comparées entre elles
def k_plus_proches(x:float, y:float, k: int)-> int:
"""
Retourne la valeur majoritaire des k plus proche voisins de (x,y)
En cas d'égalité la valeur la plus basse est retournée
"""
k_voisins = iris_set[:k] # prend les k premiers éléments de la liste
k_voisins.sort(key = lambda iris : distance(x,y, iris['petal_length'], iris['petal_width']))
dist_max = distance(x,y, k_voisins[-1]['petal_length'], k_voisins[-1]['petal_width'])
for iris in iris_set:
dist = distance(x,y, iris['petal_length'], iris['petal_width'])
if dist < dist_max:
k_voisins.pop() # retire le plus loins des k voisin
k_voisins.append(iris)
# puis on re trie les k voisins
k_voisins.sort(key = lambda iris : distance(x,y, iris['petal_length'], iris['petal_width']))
dist_max = distance(x,y, k_voisins[-1]['petal_length'], (k_voisins[-1]['petal_width'])
cpt = []
for i in range(3):
cpt.append(sum([1 for iris in k_voisins if int(iris['species']) == i]))
maxi = max(cpt)
if maxi == cpt[0]:
return 0
if maxi == cpt[1]:
return 1
return 2
|
Une simulation pour l'ensemble des valeurs d'un cadrillage
Nous voulons tester l'alglorithme des k plus proches voisins pour voir quelles classification est choisie pour tous les points d'un cadrillage avec un pas de 0.1
Complète le code suivant
| Python |
|---|
| def simulation(k:int):
"""
Parcours les x de 0 à 7 avec un pas de 0.1
les y de 0 à 2.5 avec un pas de 0.1
ajoute le point (x,y) aux listes x[c] x[c]
où c est la valeur retournée par l'algotihme des k plus proches voisin
"""
x,y = [[],[],[]], [[],[],[]]
for i in range(70):
for j in range(25):
c = k_plus_proches(......) # c est la classe retournée par k_plus proches
x[c].append(....)
y[c].append(....)
plt.scatter(x[0],y[0], color='blue')
plt.scatter(x[1],y[1], color='red')
plt.scatter(x[2],y[2], color='green')
plt.show()
|