Codage des caractères
Une évolution de l'ASCII à l'UNICODE et UTF-8.⚓︎
Le traitement de texte en informatique est apparu dès les premières générations d’ordinateurs. Au fil du temps, des normes de codage se sont imposées, évoluant pour répondre à la fois aux besoins techniques croissants et à l’internationalisation des échanges numériques.
1) Introduction⚓︎
Un ordinateur ne traite que des données binaires. Mais comment les textes, composés de caractères variés, sont-ils représentés en binaire ? Plus précisément, comment chaque caractère est-il codé pour être interprété par une machine ?
2) ASCII : le standard américain⚓︎
Avant 1960, de nombreux systèmes de codage de caractères coexistaient, souvent incompatibles entre eux. En 1960, l’ISO (Organisation internationale de normalisation) standardise le codage avec l’ASCII (American Standard Code for Information Interchange).
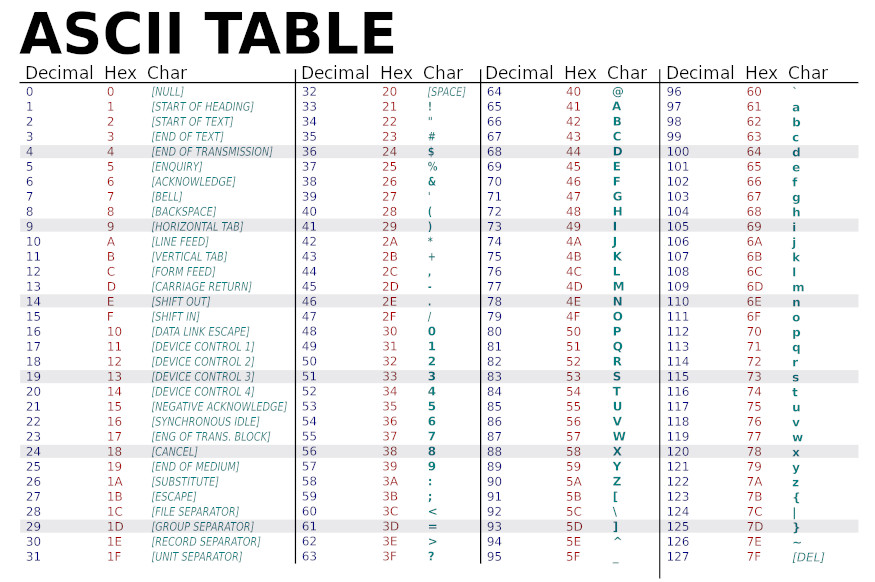
Chaque caractère est associé à un nombre binaire sur 7 bits (le 8ᵉ bit étant initialement inutilisé pour le codage, parfois utilisé comme bit de vérification), permettant de représenter 128 caractères — suffisant pour l’anglais, mais pas pour les langues utilisant des accents ou des symboles spécifiques.
Exemple : Le « A » majuscule est codé 1000001₂ (soit 65 en décimal ou 41 en hexadécimal).
Remarque : Les codes de 0 à 31 (en décimal) correspondent à des caractères de contrôle (non imprimables).
 ⚓︎
3) ISO-8859-1 : l’extension européenne⚓︎
L’ASCII ne couvre pas les besoins des langues européennes, comme le français, qui utilisent des lettres accentuées. La norme ISO-8859-1 (ou latin1) étend le codage à 8 bits, permettant de représenter 256 caractères — suffisants pour la plupart des langues européennes.
Limites :
- Ne couvre pas les alphabets non latins (chinois, japonais, arabe, etc.).
- Multiplicité des normes : chaque langue ou région peut nécessiter une norme spécifique (ex. : GB2312 pour le chinois, JIS X 0208 pour le japonais).
Problème pratique :
Un utilisateur français recevant un texte japonais doit configurer son logiciel pour afficher correctement les caractères, sous peine de voir des symboles incompréhensibles.
De plus, choisir une des normes proposées rend complexe l'édition de documents en plusieurs langues ayant des alphabets différents : une traduction français - arabe par exemple.
4) Unicode et UTF-8 : l’universalité⚓︎
Pour résoudre ces problèmes, la norme Unicode est créée en 1991. Son objectif : unifier tous les systèmes d’écriture du monde, permettant à un même document d’afficher du français, du japonais, de l’arabe, etc., sans changement de configuration.
-
Unicode est une table de référence qui attribue un numéro unique à chaque caractère.
-
UTF-8 est le système de codage le plus utilisé (notamment sur le web) pour représenter ces caractères en binaire.
-
Avantage : rétrocompatibilité totale avec l’ASCII (les 128 premiers caractères sont identiques).
- Fonctionnement : utilise un nombre variable d’octets (de 1 à 4) selon la complexité du caractère.
Tableau comparatif : ASCII, ISO-8859-1, UTF-8⚓︎
| Norme | Taille (bits) | Nombre de caractères | Couverture principale | Rétrocompatibilité |
|---|---|---|---|---|
| ASCII | 7 | 128 | Anglais, caractères de contrôle | - |
| ISO-8859-1 | 8 | 256 | Langues européennes (latin) | ASCII |
| UTF-8 | 8 à 32 | 1 112 064 | Toutes les langues du monde | ASCII |
Exemples de codage UTF-8⚓︎
1. Codage de « é » (e accent aigu)⚓︎
| Caractère | UTF-8 (hexadécimal) | UTF-8 (binaire) | Nombre d’octets |
|---|---|---|---|
| é | C3 A9 | 11000011 10101001 | 2 |
2. Codage de l’emoji « smile face » (😊)⚓︎
| Caractère | UTF-8 (hexadécimal) | UTF-8 (binaire) | Nombre d’octets |
|---|---|---|---|
| 😊 | F0 9F 98 8A | 11110000 10011111 10011000 10001010 | 4 |
Exemple concret : texte multilingue en UTF-8⚓︎
| Langue | Texte | Codage UTF-8 (hexadécimal) |
|---|---|---|
| Français | café | 63 61 66 C3 A9 |
| Japonais | こんにちは | E3 81 93 E3 82 93 E3 81 AB E3 81 A1 E3 81 AF |
| Arabe | مرحبا | D9 85 D8 B1 D8 AD D8 A8 D8 A7 |
L’évolution des normes de codage reflète la nécessité de représenter toujours plus de caractères, dans toujours plus de langues. UTF-8, grâce à sa rétrocompatibilité et sa flexibilité, s’impose aujourd’hui comme le standard universel pour le web et les systèmes modernes.