Aller au contenu

K plus proches voisins

L'algorithme des "k plus proches voisins" (en anglais "k nearest neighbors" : knn)

Afin de travailler sur un exemple, nous allons utiliser un jeu de données relativement connu dans le monde du machine learning : le jeu de données "iris".

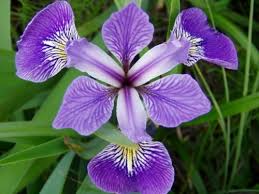
En 1936, Edgar Anderson a collecté des données sur 3 espèces d'iris : "iris setosa", "iris virginica" et "iris versicolor"

Iris Setosa⚓︎
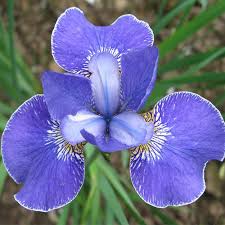
Iris Virginica⚓︎
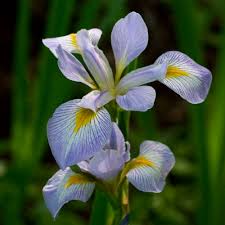
Iris Versicolor⚓︎
Pour chaque iris étudié, Anderson a mesuré (en cm) :

  • la largeur des sĂ©pales

  • la longueur des sĂ©pales

  • la largeur des pĂ©tales

  • la longueur des pĂ©tales

Par souci de simplification, nous nous intéresserons uniquement à la largeur et à la longueur des pétales.

Pour chaque iris mesuré, Anderson a aussi noté l'espèce ("iris setosa", "iris versicolor" ou "iris virginica")

Vous trouverez 50 de ces mesures dans le fichier iris.csv

En résumé, vous trouverez dans ce fichier :

  • la longueur des pĂ©tales

  • la largeur des pĂ©tales

  • l'espèce de l'iris (au lieu d'utiliser les noms des espèces, on utilisera des chiffres : 0 pour "iris setosa", 1 pour "iris versicolor" et 2 pour "iris virginica")
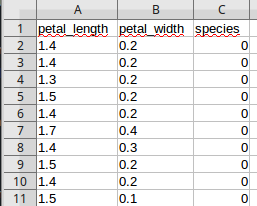
Nous pouvons représenter les données à l'aide du module Pandas :

Python
import pandas
import matplotlib.pyplot as plt
iris=pandas.read_csv("iris.csv")
x=iris.loc[:,"petal_length"]
y=iris.loc[:,"petal_width"]
lab=iris.loc[:,"species"]
plt.axis('equal')
plt.scatter(x[lab == 0], y[lab == 0], color='g', label='setosa')
plt.scatter(x[lab == 1], y[lab == 1], color='r', label='versicolor')
plt.scatter(x[lab == 2], y[lab == 2], color='b', label='virginica')
plt.legend()
plt.show()

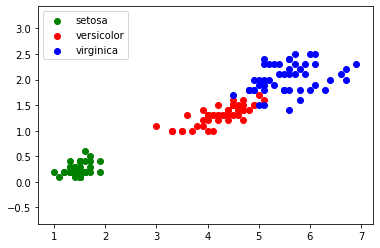
Voici ce que l'on obtient :

Graphisme sans les modules pandas et csv⚓︎

Pour s'entrainer, notamment avec la méthode split(',') qui sépare une chaîne de caractères à chaque virgule.

Chacune des lignes sera séparée en 3 chaînes qui seront ensuite converties en flottants.

Après avoir télécharger le fichier, complétez le code suivant pour obtenir les nuages de points.

Python
from matplotlib import pyplot as plt

with open("iris.csv","r") as f:
    premiere_ligne = f.readline() # la première ligne est mise de côté
    x_setosa, y_setosa = [],[]
    x_versicolor, y_versicolor = [],[]
    x_virginica, y_virginica = [],[]

    contenu = f.readlines()
    for ligne in contenu:
        l,w,s = .... # en utilisant float(...)pour convertir et split(',') pour séparer les lignes.

        # en fonction de l'espère, qui est stockée dans la variable s, on ajoute aux listes x_.... et y_... correspondantes 
        if s == 0:
            ...
            ...
        elif s == 1:
            ...
            ...
        else:
            ...
            ...

plt.scatter(x_setosa, y_setosa, color = 'g') # nuage des setosa en vert
plt.scatter(.....) # nuage des versicolor en rouge
plt.scatter(....) # nuage des virginca en bleu
plt.show()

Nous obtenons des "nuages" de points, on remarque ces points sont regroupés par espèces d'iris (pour "iris virginica" et "iris versicolor", les points ont un peu tendance à se mélanger).

Imaginez maintenant qu'au cours d'une promenade vous trouviez un iris, n'étant pas un spécialiste, il ne vous est pas vraiment possible de déterminer l'espèce.

En revanche, vous êtes capables de mesurer la longueur et la largeur des pétales de cet iris. Partons du principe qu'un pétale fasse 0,5 cm de large et 2 cm de long.

Plaçons cette nouvelle donnée sur notre graphique (il nous suffit d'ajouter la ligne "plt.scatter(2.0, 0.5, color='k')", le nouveau point va apparaitre en noir (color='k')) :
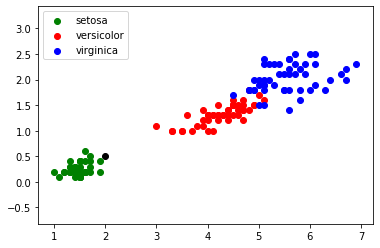
Je pense que le résultat est sans appel : il y a de fortes chances que votre iris soit de l'espèce "iris setosa".

Il est possible de rencontrer des cas plus difficiles, par exemple : largeur du pétale = 0,75 cm ; longueur du pétale = 2,5 cm :
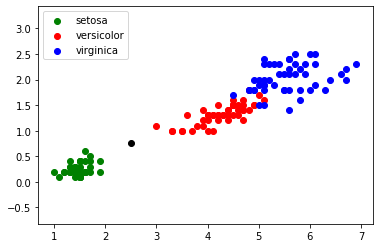
Dans ce genre de cas, il peut être intéressant d'utiliser l'algorithme des "k plus proches voisins", en quoi consiste cet algorithme :

  • on calcule la distance entre notre point (largeur du pĂ©tale = 0,75 cm ; longueur du pĂ©tale = 2,5 cm) et chaque point issu du jeu de donnĂ©es "iris" (Ă  chaque fois c'est un calcul de distance entre 2 points tout ce qu'il y a de plus classique)

  • on sĂ©lectionne uniquement les k distances les plus petites (les k plus proches voisins)

  • parmi les k plus proches voisins, on dĂ©termine quelle est l'espèce majoritaire. On associe Ă  notre "iris mystère" cette "espèce majoritaire parmi les k plus proches voisins"

Prennons k = 3
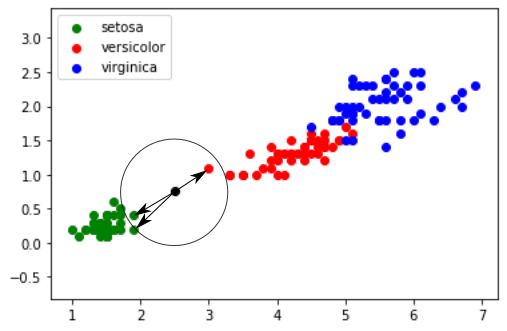
Les 3 plus proches voisins sont signalés ci-dessus avec des flèches : nous avons deux "iris setosa" (point vert) et un "iris versicolor" (point rouge).

D'après l'algorithme des "k plus proches voisins", notre "iris mystère" appartient à l'espèce "setosa".

Importance du bon choix de k⚓︎

Le choix de la bonne valeur de k est important pour de meilleurs résultats :

  • Une valeur de k trop petite peu renforcer l'iportance des valeurs "anormales" de la sĂ©rie de rĂ©fĂ©rence

  • Une valeur de k trop grande inclus des valeurs dont la similitude n'est plus justifiĂ©e.

On conseille de prendre k entre 3 et 10.

Code de l'algorithme KNN⚓︎

On souhaite écrire le code de la fonction knn qui prend en argumant la longueur l, largeur w d'un iris inconnu ainsi que le choix du nombre de voisins k utilisé pour la détermination et qui retourne la catégorie supposée de l'iris.

On utilise la fonction annexe distance qui retourne la distance euclidienne entre deux points de coordonnées respectives (x1,y1) et (x2,y2).

Dans le code suivant on dispose d'une variable iris qui contient une liste de 150 tuples au format (l,w,s) longueur l, largeur w et espece s des 150 iris de réféence.

###(Dés-)Active le code après la ligne # Tests (insensible à la casse)
(Ctrl+I)
Entrer ou sortir du mode "deux colonnes"
(Alt+: ; Ctrl pour inverser les colonnes)
Entrer ou sortir du mode "plein écran"
(Esc)
Tronquer ou non le feedback dans les terminaux (sortie standard & stacktrace / relancer le code pour appliquer)
Si activé, le texte copié dans le terminal est joint sur une seule ligne avant d'être copié dans le presse-papier
Évaluations restantes : 5/5
.128013oèPf8gbr1a3tv=uàn9xsc)7/p0d; lk5:j+,y2éhwT6e[(ES]_im.4*-050B0S0m0k0Z0E0u0D0v0E0k0u0u0o010m0Z0z010406050u0p0!0!0k0i0L040W0b0E0p0|0b0r050y13151719110z04051p1i1s0y1p110B0Z0n0;0?0^0`0?0r0g0p0k0g0S0(0z0L0m0O1g0D0O0Z0g0O0E1U0O0m0 050,0h0E0S1B0@0_011T1V1X1V0m1%1)1#0m0i1q1P0;1c0u0z0k0r0`0M011+1D010e0.0S0r0k0!0S1#2022271-2a1)2d2f0 0a0D0d0i0b0z0b0u0Z1f0r0D0*1~0i0i0S0v2A1i2i0r1q0y1P2N1`1|1{1$0B2k1E0Z0r2c2x1#1y1A0=1,2X2Z0r0b2%1#0z2G1q2L2N2@12212B2)282-0i160E1#0k1S2G0e0`030Y0Y0v2.0S1X2,0b0(0M0(0j0 0D0j1i0k2^2{102`2j2}1-2 3133350S3701393b3d3f2!3i3i3m0M3p3r223t2L2W013y0k321q340O36383a3c0*3I2-3K0l3m0l3O2K3s113S3w0`3V3X053Z3#3E3%3H2Y3J3j0$3m0$3:1j3=3u2|1C3x0b303W3A3!3C3$3G3)423+3j0G3m0G482@3?2{3T3`4i3~3F3(3e4o3h3j0R3m0R4u4a3@4d3_4f3z3Y3B3D4C413g3K0x3m0x4L3Q4w3v4O3U4Q4h4S4j4U404n4X3j0f3m0f4$2M4(4c2*4+4g3{3}4k3 4m4E4?0(0s3m0s4{3R4x3^504R3|4T4l4D3*4G3k0A0 0j0A5d4}4y4,525k555m4F3K0j3l045E5u4b5w514A544V4=433k255G3N0y3q3;4%5J5g4z4.4B4;575Q0j3-5G3/5V3P4|5Z4*5#5j4/5l4W5*455G475/5X5;4N4 5@534:565n5D4r5G4t60495Y632~5x5M675B580j4I5G4K6e4v5=646j5$5N5(693j0j4Z5G4#6s4M5f5?6w5^5%685C6B4^5G4`6G6g6I6v5L6x6l5{4p3k5a5G5c6T626V6i6X6L6y6N580M5q046?5I6h4e6.665`5P6#0M5F726`6,6|5i6~5A6!5o0M5S7d754)6W785z5O5)715,0M5.5W6f6+7h6-7j5_7a707c5}0M5 7r6t6{4P6}7k6z6O3i6b0M6d7E3s1t2=1i2%2Q0B1|2V5g4D2$1z1q2;0S2?7R7s1q4D7+2j0Z0B0`3a2L5D3A7=7@6;5*262o0S7}6m7 2N5W7G010F0 0*0e617:4~280P3m8e6u2~0e8b0Z0u0,0r0v0S8k880~040U8v763_0 0t3o7-8l1-8x0H8e0D8H3_0h0 0e0E0b0k0m8A7u8I0 0K8W8g3x0 0L8F2_8w0 8K7-8M880r8P048R8T8V8G8,048!8{8B3U8D5U8+908J8L8N3U8?8^8U8#3T8x8~948X8C040L937R8|8.2@8:908=8Q8S9c8 9i018x0w9d5g0b0 0(020g0m0C978;9a9v8`9h8$0`967-119x2B7|017^2{3K5S5j9Y7K6=802e829Z7~711#5/0D9@9r9y8a042G0m0p0i1h8/988x0U8z9W4y8D8*3s9_9R019E040(9C5?92ai4 9A9L90af0%0%ao9y0!0Z0 9m3Qac3Taf0Jatada4al2~8(aaaz98afaha28;8(ay2Ma30 9BaPap0 araE3TavaxaH8Y04aW9qaMaZasaXau8n040A0#6d6ta79)0Y7_3j5,9(7?9/846#3-0D81837b3,9=3q9V9Q0Da}a 0(5}b2ba7z3K45b89-bn7m5obl60889{8ca)0`8i048Ma75!a?0F0ra1bg5gaGbGaj040EbB9z8-a#5!9N8_bT9fbWbQ0Pb!bVa;ad9t8@9Ob)8}b$640 0Fb:9pab98b-2Y9P9n95aVb=28aN9H9Jc33x8?b~b_8ebfc07;b39!223K6bbmb4bb4q9,2fbt6A0(cl9?9^980v5F030;0i0N8U0Z1R2D0?0D1X8q1*0*0:3c0p0z1)0:0U0S202H0S0K2C8p8r8t0w0D2w9 0;0O0k0v0p2BcObh0i8p2C1*cD0e0N2G8s8u9U9dbi9#4H7{ch9:5o4Ibrcrcnbod686bEcxaQ04cW0z0Y1y8qc80`af0odrbU040T0Xcdd3d8bj6Dcm9*5Q4Zdc9.dG6#dEcw9@989{0e4fdv0r0 0Zdv0bbD2YdUdWc^0uccd2a|dCd50(6QdFd93K4^dJcs7Ld:dO9^dPdk1Xb:9gb{dk0PdXbPam8Zd$042ydY0 dub+a804e6a-88cz0 cB0n3W0S9 0:cI000Zd(dAd,7}bj6%d;b55o5ad^debu3KeCd|d}b|0 dmdoc$bTaf0#bTdV040k0z0z2c0Bb:a5eW0 ece728b#eg5!8o8q228te(e*bRe1e`b(e-a*e23QeObRejcfaFe9e 9je5b:0wfddvem04cB0k0I0b1e2C0p1~cR1)0DcVcX8tc!dpc%0Sc)0qcK34cL0m1*eQfxeybgd4cj6B6@eDco5pcqdKd=fNbd3tez9/bj5Ed7d_6n3leHdL5of#dheNelcA0D0Qc^c`fCcKc$fG20eR8q0D130icKcWc#e?d0cP2u8p0u22fFd)d+fKd-fM5Rf$eIct0j25f*fUgjf.dj9sePf}fIf9ae0 eVgyeX0u4fb f28|a6bMbQ0F0S0Led04efek909{0?0!0h0B0kea0td*gS9yeXg#gy8x0TbTa%5Gb:0Xa,4afYci0r5Db134a}eEg{fSf%5*b15/cegH4xfLg`6Bblg}d8g hbh1gl7L0jbw3qf/90fgcB0Vfu1*16fkc^0,ew1*21300Zg30:0Fc*2Gav0S2G0:ep1)esf^cJfE1*1`0Z0Nf|dngxa{ggeAd.0jclhdh26#h%hhf+6afWhng(0 3c0!0z0,1KgPgRe3c1dxg.awa@e|gyg/5tg+f8gK4 i6g;fff;h@h_erg2c+g2cT0D0l0Ddm0c8tgehZf6bhghha3k6pfPdfizh-gq6oh:gt9`8QdTe:bQith~9ydZdWbLiPb,gvhXeSi8dxb`h7h=04b^iZ0Xi#5;g^a~h$dEh)hi6ndIb9i?5*dNhmd}iIiV04igh`d1iae.0 g-gCe+b:j8j51-ici*dziM4 aCh}aL88g/aKi-h!fZh$d:i=h.6PiEhf3kd{bedBh#gi0jeCjviFeGi_jw6$iHd~hof;9}fla01*0Eev0r1y8thP34hMii0Dhu4f2z0-2GfJivh99$fOjIjz6?jyfQj_gsjPiJei8djiaIj10bh^j3jbi10 i7jd9S0 jhg%adafc60Cjl2MaAbX0 16g*kcdwgJive;k4k61Jj4kv4*g,k9g:iZ0Hg=i,fXjrg_9$5FiBeJ3j72j`iCkSj}i~dQ0 9}9 iTjm90jfiui$9Xix9$9%j@j{gojLgq7djOkn4*9{4Ek1kgehj2kzk8i5i2jp8f9ekegPkjklbEf3l1h{iZjckBibi2aSl7bNkekJh6aT3Sj;kRg|iwh*7cb7k?j^h4i}i~k`4 9{k!a0dvjoj/k+lxjsgi7CgkjMlSgpj^hldij~adk|0/kAlOlo04lqjDlQiy7OlTk@4rlWj{cvlEkXbykZ0+k#lLlllNaT0y7/7S7*7U7%1i0m7Xma2T2O0k1(m70y7V9V0*hx0/04.

Améliorations possibles :

  • La fonction distance euclidienne peut ĂŞtre remplacĂ©e par la distance de Manhattan ou alors en ne calculant pas la racine carrĂ©e, on ne change pas l'ordre pour les distances

  • plutĂ´t sur de trier toute la liste des couples, on peut la parcourir et ne mĂ©moriser Ă  chaque itĂ©ration que le k valeur les plus petites. Cela amĂ©liore la complĂ©xitĂ© d'autant plus que le rapport k / taille de la sĂ©rie est faible.