Aller au contenu

Parcours de graphes

1) algorithmes de parcours d'un graphe⚓

Nous allons commencer par nous intéresser aux algorithmes de parcours d'un graphe. L'idée du "parcours" est de "visiter" tous les sommets d'un graphe en partant d'un sommet quelconque. Ces algorithmes de parcours d'un graphe sont à la base de nombreux algorithmes trÚs utilisés : routage des paquets de données dans un réseau, découverte du chemin le plus court pour aller d'une ville à une autre...

Il existe 2 méthodes pour parcourir un graphe :

  • le parcours en largeur d'abord
  • le parcours en profondeur d'abord

a) prĂ©alable⚓

Nous allons travailler sur un graphe G(V,E) avec V l'ensemble des sommets de ce graphe et E l'ensemble des arĂȘtes de ce graphe. Un sommet u sera adjacent avec un sommet v si u et v sont reliĂ©s par une arĂȘte (on pourra aussi dire que u et v sont voisins) À chaque sommet u de ce graphe nous allons associer une couleur : blanc ou noir. Autrement dit, chaque sommet u possĂšde un attribut couleur que l'on notera u.couleur, nous aurons u.couleur = blanc ou u.couleur = noir. Quelle est la signification de ces couleurs ?

  • si u.couleur = blanc => u n'a pas encore Ă©tĂ© "dĂ©couvert"
  • si u.couleur = noir => u a Ă©tĂ© "dĂ©couvert"

L'algorithme ci-dessous permet de parcourir un graphe en largeur d'abord :

Text Only
VARIABLE
G : un graphe
s : noeud (origine)
u : noeud
v : noeud
f : file (initialement vide)

//On part du principe que pour tout sommet u du graphe G, u.couleur = blanc Ă  l'origine
DEBUT
s.couleur ← noir
enfiler (s,f)
tant que f non vide :
    u ← defiler(f)
    pour chaque sommet v adjacent au sommet u :
        si v.couleur n'est pas noir :
            v.couleur ← noir
            enfiler(v,f)
        fin si
    fin pour
fin tant que
FIN

Si on applique cet algorithme sur le graphe G ci-dessous :
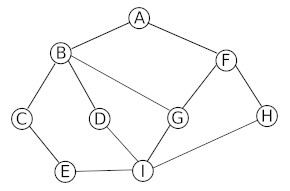
si on part du sommet A (sommet s dans l'algorithme) la "découverte" peut se faire dans l'ordre suivant : A, B, F, C, D, G, H, E et I (ATTENTION ce n'est pas la seule solution possible, par exemple A, F, B, D, C, G, H, I et E est aussi possible (il y a bien d'autres possibilités)).

Vous avez sans doute remarquĂ© que dans le cas d'un parcours en largeur d'abord, on "dĂ©couvre" d'abord tous les sommets situĂ©s Ă  une distance k du sommet "origine" (sommet s) avant de commencer la dĂ©couverte des sommets situĂ©s Ă  une distance k+1 (on dĂ©finit la distance comme Ă©tant le nombre d'arĂȘtes Ă  parcourir depuis A pour arriver Ă  destination):

En effet, pour l'exemple ci-dessus, nous avons bien :

L'algorithme ci-dessous permet de parcourir un graphe en profondeur d'abord :

Text Only
VARIABLE
G : un graphe
u : noeud
v : noeud
//On part du principe que pour tout sommet u du graphe G, u.couleur = blanc Ă  l'origine
DEBUT
PARCOURS-PROFONDEUR(G,u) :
    u.couleur ← noir
    pour chaque sommet v adjacent au sommet u :
        si v.couleur n'est pas noir :
            PARCOURS-PROFONDEUR(G,v)
        fin si
    fin pour
FIN
Vous avez dĂ» remarquer que le parcours en profondeur utilise une fonction rĂ©cursive. J'attire votre attention sur l'extrĂȘme simplicitĂ© de cet algorithme (au niveau de sa conception), c'est souvent le cas avec les algorithmes rĂ©cursifs.

Si on applique cet algorithme sur le graphe G ci-dessous :

en partant du sommet A la "découverte" peut se faire dans l'ordre suivant : A, B, C, E, I, D, G, F et H (ATTENTION, ici aussi, ce n'est pas la seule solution possible : A, F, H, I, E, C, B, D et G est aussi une solution possible (il y a bien d'autres possibilités)).

Dans le cas du parcours en largeur d'abord on "découvrait" tous les sommets situés à une distance k de l'origine avant de s'intéresser aux sommets situés à une distance k+1 de l'origine. Dans le cas du parcours en profondeur, on va chercher à aller "le plus loin possible" dans le graphe : A -> B -> C -> E -> I -> D, quand on tombe sur "un cul-de-sac" (dans notre exemple, D est un "cul-de-sac", car une fois en D, on peut uniquement aller en B, or, B a déjà été découvert...), on revient "en arriÚre" (dans notre exemple, on repart de B pour aller explorer une autre branche : G -> F -> H)

À noter que l'utilisation d'un algorithme rĂ©cursif n'est pas une obligation pour le parcours en profondeur :

Text Only
VARIABLE
s : noeud (origine)
G : un graphe
u : noeud
v : noeud
p : pile (pile vide au départ)
//On part du principe que pour tout sommet u du graphe G, u.couleur = blanc Ă  l'origine
DEBUT
empiler(s,p)
tant que p n'est pas vide :
    u ← depiler(p)
    si u.couleur n'est pas noir :
        u.couleur ← noir
        pour chaque sommet v adjacent au sommet u :
            empiler(v,p)
        fin pour
    fin si
fin tant que
FIN
Vous avez sans doute remarquĂ© que la version "non rĂ©cursive" (on dit "itĂ©rative") de l'algorithme du parcours en profondeur ressemble beaucoup Ă  l'algorithme du parcours en largeur. Il y a tout de mĂȘme une diffĂ©rence Ă  bien noter : la file est remplacĂ©e par une pile

2) cycle dans les graphes⚓

Voici un rappel de 2 définitions vues précédemment :

  • une chaine est une suite d'arĂȘtes consĂ©cutives dans un graphe, un peu comme si on se promenait sur le graphe. On la dĂ©signe par les lettres des sommets qu'elle comporte. On utilise le terme de chaine pour les graphes non orientĂ©s et le terme de chemin pour les graphes orientĂ©s.
  • un cycle est une chaine qui commence et se termine au mĂȘme sommet.

Pour diffĂ©rentes raisons, il peut ĂȘtre intĂ©ressant de dĂ©tecter la prĂ©sence d'un ou plusieurs cycles dans un graphe (par exemple pour savoir s'il est possible d'effectuer un parcours qui revient Ă  son point de dĂ©part sans ĂȘtre obligĂ© de faire demi-tour).

Voici ci-dessous un algorithme qui permet de "détecter" la présence d'au moins un cycle dans un graphe :

Text Only
VARIABLE
s : noeud (noeud quelconque)
G : un graphe
u : noeud
v : noeud
p : pile (vide au départ)
//On part du principe que pour tout sommet u du graphe G, u.couleur = blanc Ă  l'origine
DEBUT
CYCLE():
    empiler(s,p)
    tant que p n'est pas vide :
        u ← depiler(p)
        pour chaque sommet v adjacent au sommet u :
            si v.couleur n'est pas noir :
                empiler(v,p)
            fin si
        fin pour
        si u est noir :
            renvoie Vrai
        sinon :
            u.couleur ← noir
        fin si
    fin tant que
    renvoie Faux
FIN

3) Chercher une chaine dans un graphe⚓

Nous allons maintenant nous intéresser à un algorithme qui permet de trouver une chaine entre 2 sommets (sommet de départ et sommet d'arrivée). Les algorithmes de ce type ont une grande importance et sont trÚs souvent utilisés).

Text Only
VARIABLE
G : un graphe
start : noeud (noeud de départ)
end : noeud (noeud d'arrivé)
u : noeud
chaine : ensemble de noeuds (initialement vide)

DEBUT
TROUVE-CHAINE(G, start, end, chaine):
    chaine = chaine ⋃ start //le symbol ⋃ signifie union, il permet d'ajouter le noeud start à l'ensemble chaine
    si start est identique Ă  end :
        renvoie chaine
    fin si
    pour chaque sommet u adjacent au sommet start :
        si u n'appartient pas Ă  chaine :
            nchemin = TROUVE-CHAINE(G, u, end, chaine)
            si nchemin non vide :
                renvoie nchemin
            fin si
        fin si
    fin pour
    renvoie NIL
FIN

Vous noterez que l'algorithme ci-dessus est basé sur un parcours en profondeur d'abord.

4) pour aller plus loin...⚓

Il est important de noter que dans la plupart des cas, les algorithmes de recherche de chaine (ou de chemin), travaillent sur des graphes pondérés (par exemple pour rechercher la route entre un point de départ et un point d'arrivée dans un logiciel de cartographie). Ces algorithmes recherchent aussi souvent les chemins les plus courts (logiciels de cartographie). On peut citer l'algorithme de Dijkstra ou encore l'algorithme de Bellman-Ford qui recherchent le chemin le plus court entre un noeud de départ et un noeud d'arrivée dans un graphe pondéré. Si ce sujet vous intéresse, vous pouvez visionner cette vidéo qui explique le principe de fonctionnement de l'algorithme de Dijkstra.

5) Exercices : codes en Python⚓

Nous reprenons le mĂȘme graphe en exemple,

Voici l'implémentation du graphe à l'aide d'une liste d'adjacence :

Python
graphe = {
 'A' : ['B','F'],
 'B' : ['A', 'C', 'D', 'G'],
 'C' : ['B', 'E'],
 'D' : ['B', 'I'],
 'E' : ['C', 'I'],
 'F' : ['A', 'G', 'H'],
 'G' : ['B', 'F', 'I'],
 'H' : ['F', 'I'],
 'I' : ['D', 'E', 'G', 'H']}
Nombre de sommets |S| et nombre d'arĂȘtes |A|

ComplĂšte le code suivant qui retourne le nombre de sommets et d'arĂȘtes dans un graphe non orientĂ©, donnĂ© par sa liste d'adjacence

Python
1
2
3
4
5
6
7
def card_V_E(g):
'''
retiurne les cardinaux |V| et |E| dans un tuple
'''
nombre_sommets =  len(...)
nombre_aretes = sum(... for ... in g.values()) // ...
return (nombre_sommets,nombre_aretes) # remarque : les arĂȘtes sont comptĂ©es deux fois 
Parcours en largeur (BFS)

complĂšte le code suivant:

Python
def BFS(g, depart):

'''
BFS :  Breadth-First Search
retourne un parcours en largeur du graphe g
Ă  partir du sommet depart
'''

# la file est implémentée avec une liste Python
# pour défiler l'élément le plus ancien : file.pop(0)

file = [depart]
parcours = [depart] # variable du parcours

# ensemble des sommets déja découverts
decouverts = {depart} 

while len(...): # tant qu'il reste un ou des sommets dans la file
    sommet_actuel = ... # on defile le sommet
    for v in g[...]: # étude de tous les sommets adjacents (voisins)
        if v not in decouverts:
            decouverts.add(v)
            file.append(...)
            parcours.append(...)

return parcours

Avec le graphe en exemple, le code doit retourner:

Python
>>> BFS(graphe,'A')
['A', 'B', 'F', 'C', 'D', 'G', 'H', 'E', 'I']
Parcours en profondeur (DFS)

La façon la plus simple de coder le parcours en profondeur est d'utiliser la récursivité.

Pour cela nous utilisons une fonction interne, dfs_rec qui sera appelée a chaque fois qu'un sommet non encore découverts est rencontré.

Python
def DFS(g, depart):
'''
DFS :  Depth-First Search
retourne un parcours en profondeur du graphe g
Ă  partir du sommet depart

Les sommets sont colorés de 3 façons:
blanc: non découvert
gris:  découvert, en phase d'exploration des voisins
noirs: déccouverts et tous les voisins ont été découverts 
'''
parcours = [depart] # variable du parcours

# ensemble des sommets déja découverts (gris)
gris = {depart}

# ensemble de sommets complÚtement traités (noirs)
noirs = set() # création d'un ensemble vide

def dfs_rec(g, depart):
    if depart not in noirs: # pour éviter d'étudier une 2Úme fois des sommets déjà traités complÚtement

        for v in g[...]: # parcours des voisins

            if v not in ...: # le voisin n'est pas encore découvert
                gris.add(...)
                parcours.append(...)
                dfs_rec(g,v) # appel de la fonction d'exploartion Ă  partir de ce voisin

        noirs.... # indique le depart est complÚtement traité

dfs_rec(...) # premier appel de la fonction récursive interne
return parcours
Python
>>> DFS(graphe, 'A')
['A', 'B', 'C', 'E', 'I', 'D', 'G', 'F', 'H']
Parcours en profondeur (DFS) itérative

Il existe une deuxiÚme façon de coder le parcours en profondeur sans utiliser de fonction récursive.

Pour cela, nous utilisons une pile qui permet d'ajouter les sommets voisins d'un autre.

Les sommets de la pile sont dépilés (depuis le haut de la pile, les plus récents en premier) et les sommets non encore ajouté au parcours le sont ajoutés à ce dernier.

Python
def DFS_iter(g, depart):
'''
DFS :  Depth-First Search
retourne un parcours en profondeur du graphe g
Ă  partir du sommet depart

Sans utiliser la récursivité, c'est plus complexe à coder
Nous avons besoin d'une pile
'''

# la pile est implémentée avec une liste Python
# pour défiler l'élément le plus récent : pile.pop()

pile = [...] # on commence avec le premier sommet
parcours = [] # variable du parcours, vide initialement dans ce code


while len(...):
    sommet_actuel = pile.pop() # récupération du dernier sommet
    if sommet_actuel not in ...:
        parcours.append(...)
        for v in ...:
            pile.... # ajout de v Ă  la pile

return parcours

Avec l'exemple, le code doit retourner:

Python
>>> DFS_iter(graphe, 'A')
['A', 'F', 'H', 'I', 'G', 'B', 'D', 'C', 'E']

Remarque : ce code n'est pas optimisĂ© car les sommets peuvent ĂȘtre ajoutĂ©s plusieurs fois dans la pile

Question: pourquoi le parcours est ici initialement vide ?

Parcours en profondeur (DFS) itérative, version avec ajout unique à la pile

Pour éviter d'ajouter plusieurs fois les sommets dans la pile, nous itilisons une rechercher des voisins non encoore déouverts.

Liste par compréhension avec tests :

voisins_blancs = [ v for v in graphe[sommet_actuel] if v not in decouverts]

Le code est un peu plus complexe.

Python
def DFS_iter2(g, depart):
'''
DFS :  Depth-First Search
retourne un parcours en profondeur du graphe g
Ă  partir du sommet depart

Sans utiliser la récursivité, c'est plus complexe à coder
Nous avons besoin d'une pile
'''
# la pile est implémentée avec une liste Python
# pour défiler l'élément le plus récent : pile.pop()

pile = [depart]
parcours = [depart] # variable du parcours

# ensemble des sommets déja découverts
decouverts = {depart}

while len(...):
    sommet_actuel = pile[-1] # dernier sommet, le haut de la pile, il n'est pas encore dépilé
    voisins_blancs = [ v for v in graphe[sommet_actuel] if v not in decouverts]

    if voisins_blancs: # si le sommet possÚde encore des voisins non découverts
        # ajout du premier voisins non encore découverts à la pile et au parcours
        premier = voisins_blancs[..]

        decouverts.add(...) # marquage du premier voisin comme découvert

        ... # ajout du premier voisin Ă  la pile
        parcours.append(...) # et ajout au parcours
    else: # le sommet n'a plus de voisins non découverts
        ... # on le supprime de la pile

return parcours
Python
>>> DFS_iter2(graphe,'A')
['A', 'B', 'C', 'E', 'I', 'D', 'G', 'F', 'H']
Connexité d'un graphe

Adapter le code d'un des parcours pour vérifier qu'un graphe est connexe, i.e. tous les sommets sont accessible depuis le sommet depart.