Solutions de l'épreuve d'informatique commune - MP, PC, PSI⚓︎
Q1 - Représentation binaire unique⚓︎
La représentation possible qui est :
| Caractère | Code |
|---|---|
| 'a' | 0 |
| 'b' | 10 |
| 'c' | 11 |
Aucun code n'est préfixe d'un autre.
Q2 - Fonction nbCaracteres⚓︎
| Python | |
|---|---|
Complexité : \(O(n)\), où \(n\) est la longueur de la chaîne.
Q3 - Fonction listeCaracteres⚓︎
La fonction listeCaractères parcourt les caractères de la chaîne passée en argument et ajoute à listeCar tous les nouveaux caractères rencontrés.
Elle retourne donc la liste des caractères dinctincts rencontrés dans l'ordre d'apparition?.
Résultat pour s='abaabaca' : ['a', 'b', 'c']
Q4 - Complexité de listeCaracteres⚓︎
- La boucle parcourt \(\(n\)\) éléments.
- Pour chaque élément, la vérification
c in listeCara une complexité \(\(O(k)\)\) dans le pire des cas. - Complexité totale : \(\(O(n \cdot k)\)\).
Q5 - Fonction analyseTexte⚓︎
| Python | |
|---|---|
Cette fonction retourne une liste de couple (tuple) des caractères disctincts de s et leur nombre d'occurrences.
Résultat pour analyseTexte('babaaaabca') : [(b, 3), (a, 6), (c, 1)]
Q6 - Complexité de analyseTexte⚓︎
listeCaracteres(s): \(O(nk)\)nbCaracteres(c, s)pour chaque caractère \(k\) : \(O(n)\)- Complexité totale : \(O(nk + kn) = O(nk)\).
Q7 - Version optimisée avec dictionnaire⚓︎
L'utilisation d'un dictionnaire permet l'incrémentation d'une valeur en temps constant (utilisation d'une table de hachage)
| Python | |
|---|---|
Complexité : \(O(n)\) car chaque caractère est parcouru une seule fois.
Q8 - SQL : Liste des auteurs, sans doublon⚓︎
| SQL | |
|---|---|
Q9 - SQL : Fréquence d'appartion des caractères dans les oeuvres en français⚓︎
| SQL | |
|---|---|
Cette réponse qui est la plus "évidente" utilise une sous-requête après le / pour calculer les fréquences.
Le rraport du jury dit que la question demandait UNE requête et rejette l'utilisation des sous-requêtes.
Je pense qu'une sous requête peut être considérée comme partie d'une requête.
Pour répondre à la question sans sous-requête, je ne vois pas d'autres solution que l'utilisation de la clause OVER qui n'est pas au programme d'ITC.
| SQL | |
|---|---|
Q10 – Proposer l'intervalle correspondant à la chaîne s='bac'.⚓︎
L'algorithme de codage arithmétique commence avec l'intervalle initial [0;1[[0;1[ et affine cet intervalle à chaque caractère successif. Étapes du codage de s='bac' :
-
Le premier caractère est 'b'. On commence avec l'intervalle [0;1[ et l'intervalle pour 'b' est [0.2;0.3[. étendue 0.1
-
Le deuxième caractère est 'a'. On affine l'intervalle [0.2;0.3[ en prenant le sous-intervalle correspondant à 'a', qui est [0.2;0.22[. (0.2 x 0.1 = 0.22), étendue 0.02
-
Le troisième caractère est 'c'. On affine l'intervalle [0.2;0.25[ en prenant le sous-intervalle correspondant à 'c', qui est [0.24;0.25[. 0.2 + 0.3 x 0.02 = 0.206 à 0.2 + 0.5 x 0.02 = 0.21
Donc, l'intervalle final correspondant à la chaîne s='bac' est [0.206;0.21[.
Q11 - Écrire la fonction codage(s:str) -> (float, float).⚓︎
La fonction codage doit appliquer l'algorithme de codage arithmétique à la chaîne de caractères s.
À chaque étape, la fonction codeCar est utilisée pour affiner l'intervalle.
Q12 - Déterminer le caractère qui suit 'ad' dans la chaîne codée par x = 0.123.⚓︎
Nous devons maintenant utiliser l'algorithme de décodage arithmétique pour trouver le caractère qui suit ad et déterminer son sous-intervalle. Étapes de décodage :
Le dernier intervalle obtenu après avoir décodé 'ad' est [0.1,0.18[.
Le nombre x=0.123 appartient à cet intervalle.
Le caractère suivant est celui dont l'intervalle contient x=0.123 = 0.1 + 0.023 = 0.10 + 0.08 * 0.2875.
Or 0.2875 appartien à [0.2;0.3[ qui est l'intervalle de b.
Le caractère qui suit 'ad' dans la chaîne codée par x=0.123 est donc 'b'.
Q13 – Indiquer deux chaînes qui peuvent correspondre au flottant 0.2.⚓︎
Pour déterminer les chaînes qui peuvent correspondre au flottant 0.2, il faut que la chaîne commence par un b.
De plus le a est codé par 0 et ne change donc pas la valeur du codage.
Ainsi, deux chaînes possibles correspondant au flottant 0.2 sont :
-
b -
ba
L'ambiguïté vient du fait que a est codé avec 0 ce qui sera changé par la suite pour ne coder par 0 que le caractère final #.
Q14 - Fonction decodage(x:float)->str⚓︎
La fonction decodage(x) permet de déterminer la chaîne de caractères correspondante à une valeur x donnée, selon les intervalles définis par les caractères.
Voici un exemple d'implémentation :
Q15 - Nombre de sommets et d'arcs du graphe⚓︎
Le graphe décrit dans la question est constitué de sommets organisés en couches successives, chaque couche représentant un symbole observé. Le nombre de sommets et d'arcs dans ce graphe est donné par :
-
Nombre de sommets :
Text Only 1 2 3 4 5 6 7
Il y a K sommets pour chaque observation (état possible pour chaque symbole observé). Il y a N observations (couches de symboles observés). Donc, le nombre total de sommets est : Nombre de sommets = `N * K` -
Nombre d'arcs :
Text Only 1 2 3 4 5 6 7
Chaque sommet de la couche j (pour chaque observation) est relié à tous les sommets de la couche suivante j + 1.

Donc, chaque couche j génère K * K arcs.

Le nombre d'arcs entre les couches successives est donc :

Nombre d'arcs = `(N - 1) * K * K`
Q16 - Graphe pondéré associé à la séquence [2, 0]⚓︎
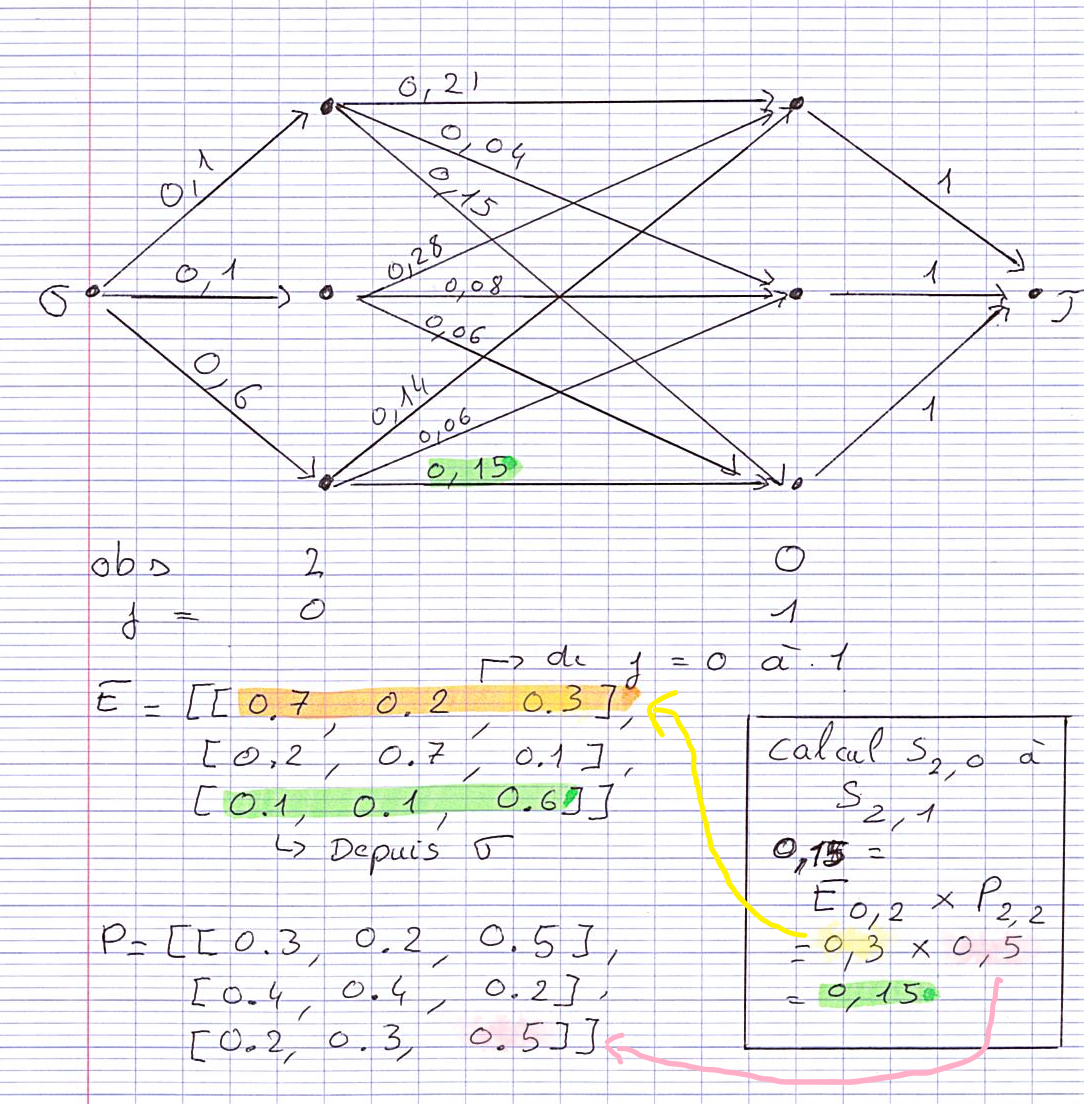
Avec la séquence observée [2, 0] et les matrices de probabilités E et P fournies dans l'énoncé, voici comment construire le graphe pondéré :
| Text Only | |
|---|---|
1 2 | |
E = [[0.7, 0.2, 0.3],
     [0.2, 0.7, 0.1],
     [0.1, 0.1, 0.6]]
Matrice des probabilités de transition P :
| Text Only | |
|---|---|
1 | |
P = [[0.3, 0.2, 0.5],
         [0.4, 0.4, 0.2],
         [0.2, 0.3, 0.5]]
Construction du graphe :
Les arcs depuis \(\sigma\) sobtiennent avec la dernière ligne de la matrice E (car 2 est observé).
Les arc depuis les sommets internes s'obtiennent par produit.
Q17 - Nombre de chemins entre σ et τ (en fonction de N et K)⚓︎
Le nombre de chemins possibles entre le sommet source σ et le sommet cible τ dans un graphe comme celui décrit dans l'énoncé peut être estimé comme suit :
| Text Only | |
|---|---|
1 2 3 | |
En termes de notation asymptotique, le nombre de chemins possibles entre σ et τ est donc de l'ordre de O(K^N).
| Text Only | |
|---|---|
1 | |
Q18 - Fonction maximumListe⚓︎
Cette fonction retourne la valeur maximale et son premier indice d'apparition.
Q19 - Fonction glouton⚓︎
Q20 - Complexité de l'approche gloutonne⚓︎
L'algorithme parcourt les observations une seule fois avec un choix à chaque étape parmi \(K\) possibilités. La complexité est donc \(O(NK)\).
Q21 - Résultat de l'algorithme glouton⚓︎
En appliquant l'algorithme glouton à la figure 4, le chemin sélectionné est celui qui maximise la probabilité locale.
Donc [0,0] dans la figure 4.
Cette approche n'est pas toujours optimale car elle ne considère pas l'effet cumulé des décisions précédentes.